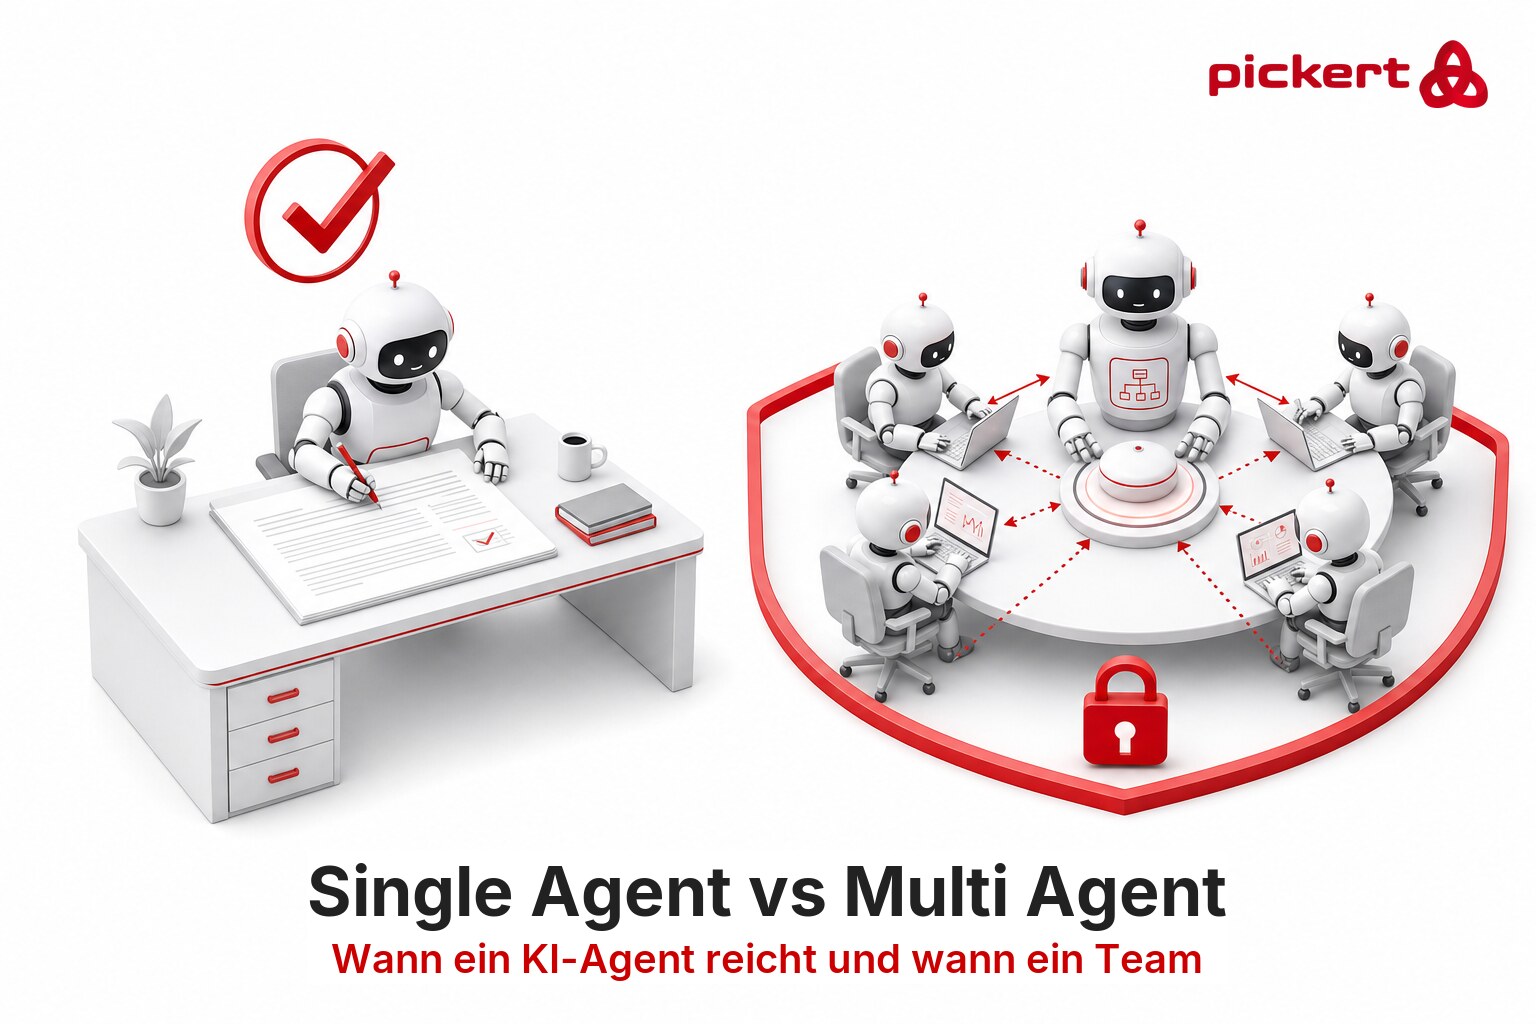
Wann ist ein Single Agent besser und wann ein Multi Agent-Team? Auf Deutsch: Ein einzelner KI-Agent erledigt eine Aufgabe von Anfang bis Ende allein. In einem KI-Agenten-Team (Multi-Agenten-System) teilen sich mehrere Agenten mit eigenen Rollen die Arbeit, und ein Orchestrator koordiniert sie. Wann ist was besser geeignet?
Ein Team lohnt sich, wenn sich die Aufgabe sauber aufteilen lässt und die Mehrkosten tragbar sind. Sonst ist ein guter Einzelagent vermutlich die klügere Wahl.
Wenn du keine Lust hast weiterzulesen reicht das im Prinzip schon: Versuche es erst einmal mit einem einzelnen Agent!
Klingt nach einer klaren Antwort, aber im Netz stehen sich zwei Lager gegenüber: „Team schlägt Einzelagent um 90 Prozent“ auf der einen Seite, „Baut keine Multi-Agenten“ auf der anderen. Für diesen Artikel haben wir die Studien und Engineering-Berichte dazu ausgewertet und Zahlen nur übernommen, wo wir sie im Original geprüft haben. Das Ergebnis: Beide Lager haben recht, für unterschiedliche Aufgaben.
Single Agent vs Multi Agent: Was ist der Unterschied?
Ein einzelner Agent ist ein Sprachmodell, das in einer Schleife plant, Werkzeuge nutzt (E-Mail, CRM, Kalender) und alles in einem durchgehenden Kontext behält.
Ein Team besteht aus mehreren solcher Agenten. Jeder hat eine Rolle, einen eigenen Kontext und eigene Werkzeuge, und ein Orchestrator (bei Anthropic heißt er Lead-Agent) verteilt die Aufgaben und sammelt die Ergebnisse ein. Wie das in unserem Alltag aussieht, steht in KI-Agenten im Mittelstand.
Wann reicht ein einzelner KI-Agent aus?
Die Hersteller sind sich hier erstaunlich einig. Anthropic empfiehlt, die einfachste Lösung zu suchen und die Komplexität nur zu erhöhen, wenn es nötig ist. OpenAI rät im Practical Guide, zuerst die Fähigkeiten eines einzelnen Agenten auszureizen, weil mehr Agenten zusätzliche Komplexität und Overhead mitbringen. Und Microsoft schreibt im Azure Architecture Center (Stand Februar 2026): die niedrigste Komplexitätsstufe nehmen, die zuverlässig reicht.
Cognition, das Team hinter dem Coding-Agenten Devin, geht in „Don’t Build Multi-Agents“ noch weiter. Wenn Agenten parallel arbeiten, treffen sie Entscheidungen auf Basis unterschiedlicher Annahmen. Im Beispiel baut ein Subagent den Spielhintergrund, der andere die Spielfigur, und am Ende passt der Stil nicht zusammen. Ein einzelner, durchgehender Agent bringt es nach Cognitions Erfahrung „sehr weit“.
Die breiteste kontrollierte Studie dazu kommt von Google Research und MIT (260 Konfigurationen, sechs Benchmarks, Preprint, Stand April 2026). Bei Aufgaben, in denen ein Schritt auf dem anderen aufbaut, wurde jede getestete Team-Variante schlechter, bei Planungsaufgaben um 39 bis 70 Prozent. Und wenn ein einzelner Agent eine Aufgabe schon zu mehr als 45 Prozent richtig löst, wird der Ertrag zusätzlicher Agenten in der Studie negativ.
Dazu passt ein Preprint von Tran und Kiela (April 2026): Bei gleichem Rechenbudget schneiden einzelne Agenten beim mehrstufigen Schlussfolgern gleich gut oder besser ab als Teams. Viele berichtete Teamvorteile lassen sich laut den Autoren besser durch zusätzlich eingesetzte Rechenleistung und Kontexteffekte erklären.
Ich sag es mal so: Ein Team klingt in der Praxis erst einmal logisch. Im Marketing macht ja typischerweise auch nicht eine Person alle Aufgaben. Es kommt immer darauf an! Es kann sinnvoll sein, Social Media und PR zu trennen, muss es aber nicht. Wo es nach unserer eigenen Erfahrung sinnvoll ist, wenn wirklich technische Komponenten mit reinspielen. Also beispielsweise technische Änderungen an einer Website. Dann sollte der Marketing-Agent da nicht dran „herumpfuschen“, sondern an einen entsprechenden Agent delegieren. Und genau so machen wir das.
Meine Empfehlung: Starte erst einmal mit einem Agenten. Wenn du an eine Grenze stößt, die du belegen kannst (der Agent verliert bei langen Aufgaben den Faden oder wählt bei vielen ähnlichen Werkzeugen falsch), ergänze weitere Agents, wo die Qualität abnimmt.
Wann lohnt sich ein KI-Agenten-Team?
Anthropic hat für seine Recherchefunktion ein Team gebaut: Ein Lead-Agent plant, mehrere Subagenten suchen parallel. In der eigenen Auswertung (13.06.2025) schlug dieses Team (Opus 4 als Lead, Sonnet 4 als Subagenten) einen einzelnen Opus-4-Agenten um 90,2 Prozent. Das Beispiel: alle Vorstandsmitglieder der IT-Unternehmen im S&P 500 finden. Das Team zerlegte die Aufgabe und fand die Antwort, der einzelne Agent suchte langsam nacheinander und scheiterte.
Dasselbe Muster zeigt die Google-und-MIT-Studie: Bei zerlegbarer Finanzanalyse lag das beste Team bis zu 80,8 Prozent über dem einzelnen Agenten. Beides sind Aufgaben, die sich in unabhängige Teile zerlegen lassen und bei denen vor allem gelesen und gesammelt wird. LangChain ordnet es so ein: Systeme, die vor allem lesen, sind leichter zu bauen als solche, die schreiben. Anthropic selbst räumt ein, dass es bei den meisten Coding-Aufgaben weniger parallelisierbare Teile gibt als bei Recherche.
Weitere Gründe für ein Team nennt Microsoft: getrennte Sicherheitsgrenzen pro Agent und parallele Spezialisierung. Dazu kommt der Kontext. Subagenten arbeiten mit eigenem, sauberem Kontextfenster und geben nur eine verdichtete Zusammenfassung zurück (oft 1.000 bis 2.000 Tokens), während der Lead-Agent den Überblick behält.
Der größte Praxistest: 16 Agenten bauten in knapp 2.000 Sitzungen über zwei Wochen einen C-Compiler, der Linux 6.9 übersetzen kann. Kosten: knapp 20.000 Dollar. Geholfen hat das Team erst, nachdem die Aufgabe aufteilbar gemacht wurde: Anfangs liefen alle 16 Agenten in denselben Fehler und überschrieben gegenseitig ihre Änderungen. Ein Referenz-Compiler als Prüfmaßstab löste das, und der Autor schreibt, dass der Großteil seiner Arbeit in Tests und Umgebung floss.
Bei uns war das mal so schlimm, dass Sub-Agents ein ganzes Wochenende lang Ping-Pong gespielt haben, zu keinem Ergebnis kamen und sich gegenseitig beschuldigt haben. Ich mein… excuse me? Ihr seid doch keine Menschen! Aber sie „simulieren“ an manchen Stellen solches Verhalten ganz schön überzeugend.
Was kostet ein Agententeam im Vergleich zu einem Agenten?
Mehr, und zwar deutlich. Nach Anthropics eigenen Daten brauchen Agenten etwa viermal so viele Tokens wie ein Chat, Multi-Agenten-Systeme etwa fünfzehnmal.
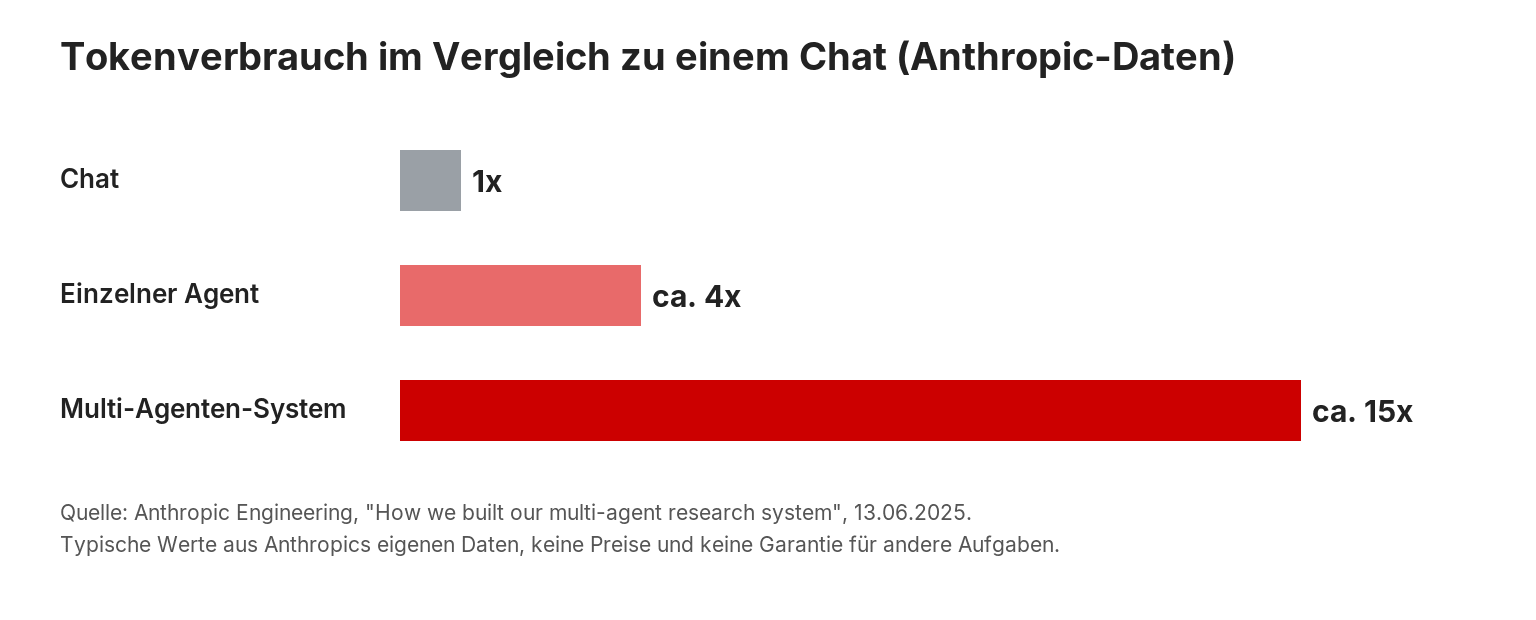
Der Tokenverbrauch treibt auch die Leistung: In Anthropics BrowseComp-Auswertung erklärte er allein 80 Prozent der Unterschiede. Das spricht dafür, dass ein Teil des Teamvorteils gekaufte Rechenleistung ist. Microsoft weist darauf hin, dass Multi-Agenten-Systeme die Modellaufrufe vervielfachen, weil jeder Agent Tokens für Anweisungen, Kontext und Werkzeuge braucht.
Anthropic schreibt selbst, dass sich ein Team nur lohnt, wenn der Wert der Aufgabe hoch genug ist, um die Mehrleistung zu bezahlen.
Wo gehen in Agententeams Informationen und Qualität verloren?
An den Übergaben, also dem Kernpunkt eines Teams. Anthropic nennt es „Stille Post“ und lässt Subagenten ihre Ergebnisse deshalb als Dateien ablegen, statt alles durch den Lead-Agenten zu schicken. Cognition fordert, volle Verläufe zu teilen statt einzelner Nachrichten (was des übrigen den Tokenverbrauch weiter nach oben treibt).
Die MAST-Studie wertete über 1.600 Abläufe aus sieben Multi-Agenten-Frameworks aus und fand 14 Fehlerarten in drei Gruppen (Systemdesign, Abstimmung zwischen Agenten, Prüfung der Ergebnisse). Die Gewinne auf gängigen Benchmarks seien oft gering, schreiben die Autoren.
Die Google-und-MIT-Studie zeigt, was eine Prüfstelle bewirkt: Unabhängige Agenten ohne gegenseitige Prüfung verstärkten Fehler um das 17,2-Fache, mit einem zentralen Orchestrator nur um das 4,4-Fache. Dazu kommt das Debugging. Agenten treffen dynamische Entscheidungen und verhalten sich auch bei gleichem Prompt nicht identisch, schreibt Anthropic, deshalb braucht es durchgehende Protokollierung.
Mein Fazit: Ein Team ohne prüfende Instanz ist ein Fehlerverstärker.
Was ändert sich bei Sicherheit, Rechten und Kontrolle?
Mehr Agenten heißen mehr Angriffsfläche. Das OWASP Top 10 für Agentic Applications (Dezember 2025) nennt drei Punkte, die bei Teams besonders zählen: Die laufende Kommunikation zwischen Agenten vergrößert die Angriffsfläche. Ein Agent ohne eigene, geführte Identität macht kleinste Rechte nicht durchsetzbar. Und ein einzelner Fehler (Halluzination, manipulierte Eingabe) kann sich über mehrere Agenten fortpflanzen.
Praktisch heißt das: Jeder Agent bekommt nur die Rechte seiner Rolle (bei Datenbanken zum Beispiel nur Lesen), und bei folgenreichen Aktionen gibt ein Mensch frei. Das ist auch unser Grundsatz, den wir in Automatisiere smart, nicht blind beschrieben haben. Zur Haftung bei Agentenfehlern machen wir hier keine Rechtsaussage. Voraussetzung für Nachvollziehbarkeit sind in jedem Fall protokollierte Übergaben.
Ändert die neue Sonnet-Version die Antwort?
Claude Sonnet 5.5 erschien am 28.09.2026. Laut Anthropics Ankündigung erreicht es 70,6 Prozent auf Terminal-Bench 4.0 (Sonnet 5: 10,3 Prozent), ist über 30 Prozent schneller und kostet bei gleichem Preis pro Token bis zu 30 Prozent weniger pro Aufgabe, weil es weniger Tokens braucht. Stark ist es bei klar umrissenen Aufgaben, bei komplexer, offener Arbeit bleibt Opus 5.5 laut Anthropic klar stärker.
Was folgt daraus für die Teamfrage? Eine begründete Richtung, kein Ergebnis. Ein stärkerer Einzelagent schafft mehr Aufgaben allein und genau dann schrumpft der Teamvorteil: Gao et al fanden schon 2025, dass der Vorteil von Multi-Agenten-Systemen mit besseren Modellen abnimmt, und die Google-und-MIT-Studie sieht ab etwa 45 Prozent Genauigkeit des Einzelagenten negative Erträge zusätzlicher Agenten.
Ein Detail aus der Ankündigung passt dazu: Bei einem Coding-Benchmark erzielte Sonnet 5.5 auf der höchsten Stufe weniger Punkte, weil es häufiger einen Code-Review auf viele Subagenten verteilte. Das führte zu Zeitüberschreitungen und überflüssigen Änderungen. Mehr Agenten sind also auch bei neuen Modellen nicht automatisch besser.
Ehrlich gesagt: Einen kontrollierten Vergleich von Team und Einzelagent mit Sonnet 5.5 kennen wir nicht, und die zitierten Studien testeten ältere Modelle (die Google-und-MIT-Studie unter anderem Claude Sonnet 4.5). Behandle die Richtung deshalb als Erwartung und teste an deiner eigenen Aufgabe.
Wir können uns also ganz einfach merken:
Je besser die Modelle, desto überflüssiger sind Teams, weil die Modelle leistungsfähiger sind und Teams gleichzeitig an den Übergaben zu viel Information verlieren und den Tokenverbrauch mehr oder weniger exponentiell nach oben katapultieren. Qualitätsverluste durch Missverständnisse noch nicht berücksichtigt.
So entscheidest du: Single Agent oder Multi Agent in sieben Fragen
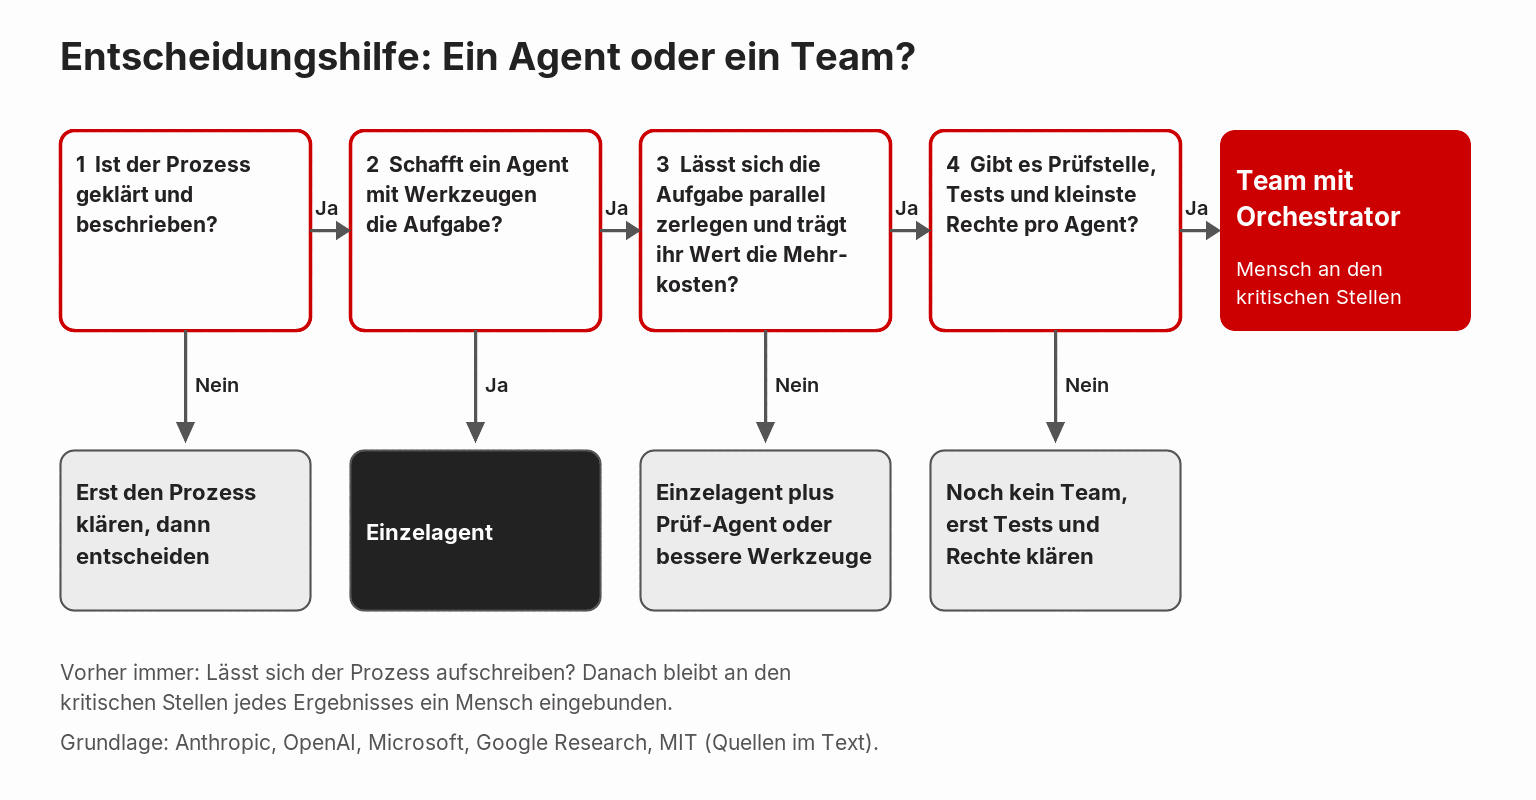
- Ist der Prozess geklärt und beschrieben? Wenn nein, kläre ihn zuerst. Das ist unser Grundsatz, und kein Agent ersetzt diesen Schritt.
- Schafft ein einzelner Agent mit den richtigen Werkzeugen die Aufgabe? Wenn ja, nimm den Einzelagenten.
- Lässt sich die Aufgabe in unabhängige Teile zerlegen, die parallel laufen? Bauen die Schritte aufeinander auf oder wird viel geschrieben, bleib beim Einzelagenten.
- Trägt der Wert der Aufgabe die Mehrkosten? Als Orientierung aus Anthropics Daten: etwa 15-mal so viele Tokens wie ein Chat bei einem Team, etwa 4-mal so viele bei einem einzelnen Agenten.
- Gibt es eine zentrale Prüfstelle und gute Tests? Ohne sie verstärken sich Fehler.
- Hat jeder Agent nur die Rechte seiner Rolle, und sind Übergaben protokolliert?
- Ist an den kritischen Stellen ein Mensch eingeplant?
Nur wenn die Fragen 3 bis 7 sauber mit Ja beantwortet sind, lohnt ein Team. Die Grafik fasst es in vier Schritten zusammen.
Wie startest du mit KI-Agenten?
Nimm einen Prozess, der bei euch Zeit frisst, und prüfe, ob er für einen Agenten taugt. Genau das macht unsere KI-Prozessanalyse: Sie bewertet den Prozess in etwa einer Viertelstunde und zeigt dir, ob ein Agent, ein klassischer Workflow oder eine Mischung der bessere Weg ist. Warum der Prozess vor dem Agenten kommt, erklärt Warum KI schlechte Prozesse nicht rettet.
Wir arbeiten selbst mit KI-Agenten als kleinem Team, orchestriert mit PIO (Pickert Intelligent Orchestration), auf einer Plattform, die wir nutzen und mitentwickeln. Und gerade deshalb sagen wir dir: Für den Start reicht meist einer.
Häufig gestellte Fragen zu Single Agent vs Multi Agent
Was ist der Unterschied zwischen einem einzelnen KI-Agenten und einem Multi-Agenten-System?
Ein einzelner KI-Agent erledigt eine Aufgabe von Anfang bis Ende allein, mit einem durchgehenden Kontext und seinen Werkzeugen. Ein Multi-Agenten-System (ein KI-Agenten-Team) verteilt die Aufgabe auf mehrere Agenten mit eigenen Rollen, eigenem Kontext und eigenen Werkzeugen. Ein Orchestrator plant, verteilt die Arbeit und führt die Ergebnisse zusammen. Dafür braucht das Team mehr Rechenleistung und mehr Abstimmung.
Wann reicht ein einzelner KI-Agent aus?
Immer dann, wenn die Schritte der Aufgabe aufeinander aufbauen und ein Agent mit den richtigen Werkzeugen sie schafft. Anthropic, OpenAI und Microsoft empfehlen übereinstimmend, mit der einfachsten Lösung zu starten. In der Google-und-MIT-Studie wurden Teams bei sequenziellen Planungsaufgaben um 39 bis 70 Prozent schlechter. Auch der Prozess muss vorher geklärt sein, sonst hilft kein Agent.
Wann lohnt sich ein KI-Agententeam?
Bei breiten Aufgaben, die sich in unabhängige Teile zerlegen lassen und bei denen vor allem gelesen und gesammelt wird, zum Beispiel Recherche oder die Prüfung vieler Unterlagen. Anthropics Rechercheteam schlug in der eigenen Auswertung einen einzelnen Agenten um 90,2 Prozent. Dazu kommen Gründe wie getrennte Sicherheitsgrenzen pro Agent oder ein Kontext, der in ein einzelnes Fenster nicht passt. Voraussetzung sind eine zentrale Prüfstelle, gute Tests und ein Aufgabenwert, der die Mehrkosten trägt.
Was kostet ein Multi-Agenten-System im Vergleich zu einem einzelnen Agenten?
Preise in Euro hängen von Modell und Aufgabe ab, deshalb hilft ein Faktor. Nach Anthropics eigenen Daten brauchen Agenten etwa viermal so viele Tokens wie ein Chat und Multi-Agenten-Systeme etwa fünfzehnmal. Der Tokenverbrauch allein erklärte in Anthropics Auswertung 80 Prozent der Leistungsunterschiede. Rechne deshalb vorher durch, ob der Wert der Aufgabe die Mehrkosten trägt.
Machen neuere Modelle wie Claude Sonnet ein Agententeam überflüssig?
Überflüssig werden Teams nicht, aber der Einzelagent reicht für mehr Aufgaben. Studien zeigen, dass der Vorteil von Teams mit stärkeren Modellen schrumpft. Claude Sonnet 5.5 (28.09.2026) ist laut Anthropic schneller und braucht weniger Tokens pro Aufgabe. Einen kontrollierten Vergleich zwischen Team und Einzelagent mit diesem Modell kennen wir noch nicht, es bleibt also eine begründete Erwartung.
Wie viele KI-Agenten braucht ein Mittelstandsunternehmen für den Start?
Für den Start genügt ein Agent mit einer klar beschriebenen Aufgabe und einem Menschen, der an den kritischen Stellen freigibt. Anthropic skaliert die Teamgröße selbst nach der Aufgabe: einfache Faktenfragen mit einem Agenten, Vergleiche mit zwei bis vier Subagenten, komplexe Recherche mit mehr als zehn. Ein Team lohnt sich erst, wenn der einzelne Agent an eine Grenze stößt, die du belegen kannst.